在数字化浪潮席卷全球的今天,从大数据到人工智能的演进已成为科技发展的核心叙事。我们每天都在产生海量数据,却往往困惑于如何将这些数据转化为真正的智能。而在这一转化过程中,人工智能基础软件开发正是那座必须跨越的桥梁。从大数据到人工智能,我们还有多远的路要走?
一、大数据与人工智能:不是线性延续,而是生态跃迁
许多人误以为大数据与人工智能只是技术演进的先后阶段——先攒数据,再跑模型。但现实远比这复杂。大数据的核心价值在于“记录与洞察”,它解决的是数据存储、清洗、查询和统计分析的问题。而人工智能追求的是“理解与决策”,它要求系统能从数据中学习规律、做出预测并自主优化。
两者之间存在着巨大的能力鸿沟。举个例子:一家电商企业可以通过大数据分析知道“谁在什么时间买了什么”,但要靠AI预测“下一位用户想买什么、为什么想买”,就需要全新的算法和算力基础设施。而这套基础设施,恰恰依赖于人工智能基础软件。
二、什么是人工智能基础软件开发?它为何关键?
人工智能基础软件,通常包括:
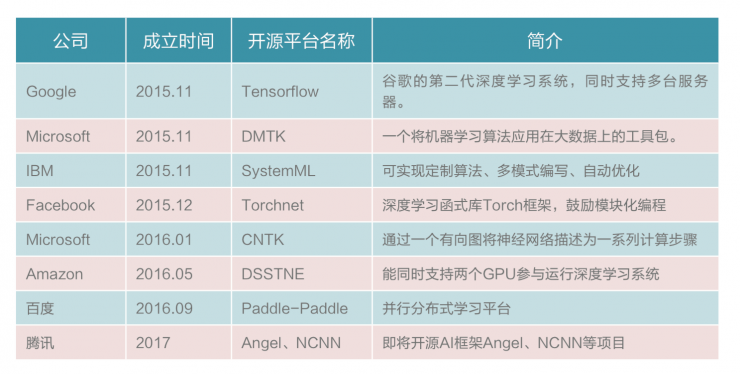
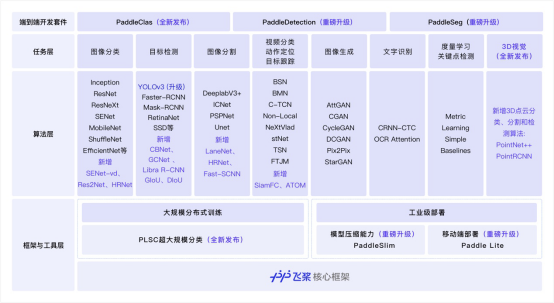
- 深度学习框架(如TensorFlow、PyTorch、PaddlePaddle)
- 自动机器学习(AutoML)平台
- 模型训练与推理引擎
- 数据标注与管理工具
- 分布式训练与调度系统
- 模型压缩与部署工具链
这些基础软件的成熟度,直接决定了AI应用落地的效率、成本和上限。没有高性能的框架,训练一个大模型可能要耗时数周;没有高效的推理引擎,自动驾驶的毫秒级响应就无法实现;没有灵活的AutoML平台,中小企业便难以跨越AI技术门槛。
换句话说,人工智能基础软件是将大数据“原料”加工为智能“成品”的中央厨房。没有它,数据再多也只是沉睡的矿山。
三、当前差距:从哪里来,差在哪里?
从大数据到人工智能(尤其是基础软件层面),我们面临几个系统性缺口:
- 底层框架自主性不足:虽然国内已有PaddlePaddle、OneFlow等优秀框架,但在全球生态、社区活跃度和算子丰富度上,与国际领先框架仍有差距。
- 生态割裂与适配成本高:数据格式、通信协议、硬件指令集不统一,导致从数据处理到模型训练的转换充满摩擦。
- 工程化能力滞后于算法研究:大量研究停留在论文层面,而基础软件开发需要的健壮性、可扩展性和稳定性,需要全职工程团队耗费数年打磨。
- 人才结构失衡:算法工程师很多,但同时精通系统编程、分布式计算和编译优化的基础软件人才极为稀缺。
四、走过的路与未来的距离:阶段性判断
如果把“大数据”视为起点,把“通用人工智能基础软件完备”视为一个远期的终点,可以粗略分为四个阶段:
- 第一阶段:能存会用——大数据平台普及,数据分析常规化。我们已基本完成。
- 第二阶段:能训能推——主流深度学习框架成型,预训练模型开源。我们正处于此阶段中后期。
- 第三阶段:高效可靠——自动调优、低成本推理、跨硬件兼容、安全可信成为标配。目前方兴未艾,道路尚远。
- 第四阶段:自主智能——基础软件具备持续学习、自我演进的能力。这一阶段预计至少仍需5–10年探索。
所以对“还有多远”的回答是:方向明确,差距在中后段,但并非遥不可及。
五、破局之道:基础软件要走的三条路
1. 拥抱开源与标准协同
单一公司很难做全栈,但可以通过开源共创降低开发成本、建立生态信任。同时推动MLIR、ONNX等中间表示标准化,打通数据到模型的管道。
2. 场景驱动的研发闭环
基础软件不能“闭门造车”。应该针对自动驾驶、生物计算、智慧工业等高价值场景,提炼共性需求,反向推动平台优化。
3. 算力-软件-硬件协同设计
未来的AI基础软件必须感知底层(GPU、NPU、存内计算)并以张量编译器、图优化器等技术深度适配。只有软硬一体,才能极限释放效能。
六、距离不远,但路必须一步一步走
从大数据到人工智能,绝不会是一夜之间的飞跃,也不会仅是几个大模型的发布。真正的智能流淌在基础软件的长期打磨中——它隐藏在每一次训练日志里、每一行索引优化制度中、每一个自动算子熔合的设计里。我们现在走在这条道路上很久了,但完全竣工仍需时间。想按快进键是不切实际的,但更有效的策略是:调稳研发引擎,耐心并坚定地往前走。人工智能时代的核心软件皇冠,正在靠近够得着的那一天。